O GPT-6.1 Sol saiu em 29 de setembro de 2026, sete dias depois do GPT-6 Sol. Não é um novo topo do Intelligence Index. A Artificial Analysis o coloca em 52, um ponto atrás do GPT-6 Astra em 53, quatro pontos à frente do GPT-6 Sol em 48, e cinco à frente do GPT-5.6 Sol em 47. O Opus 5.5 ainda lidera esse gráfico em 58. O Sonnet 5.5 fica em 56.
A conta é a parte que se moveu. No esforço máximo, uma tarefa do Intelligence Index custa US$ 0,72, contra US$ 3,26 do Astra, US$ 1,05 do GPT-6 Sol e US$ 1,99 do GPT-5.6 Sol. Menos de um quarto do Astra, e 31% abaixo do Sol que ele substitui. O preço de tabela não mudou. A entrada continua em US$ 2 por milhão de tokens e a saída em US$ 10. O corte novo é a leitura de cache: US$ 0,10, um desconto de 95%, metade dos US$ 0,20 do GPT-6 Sol.
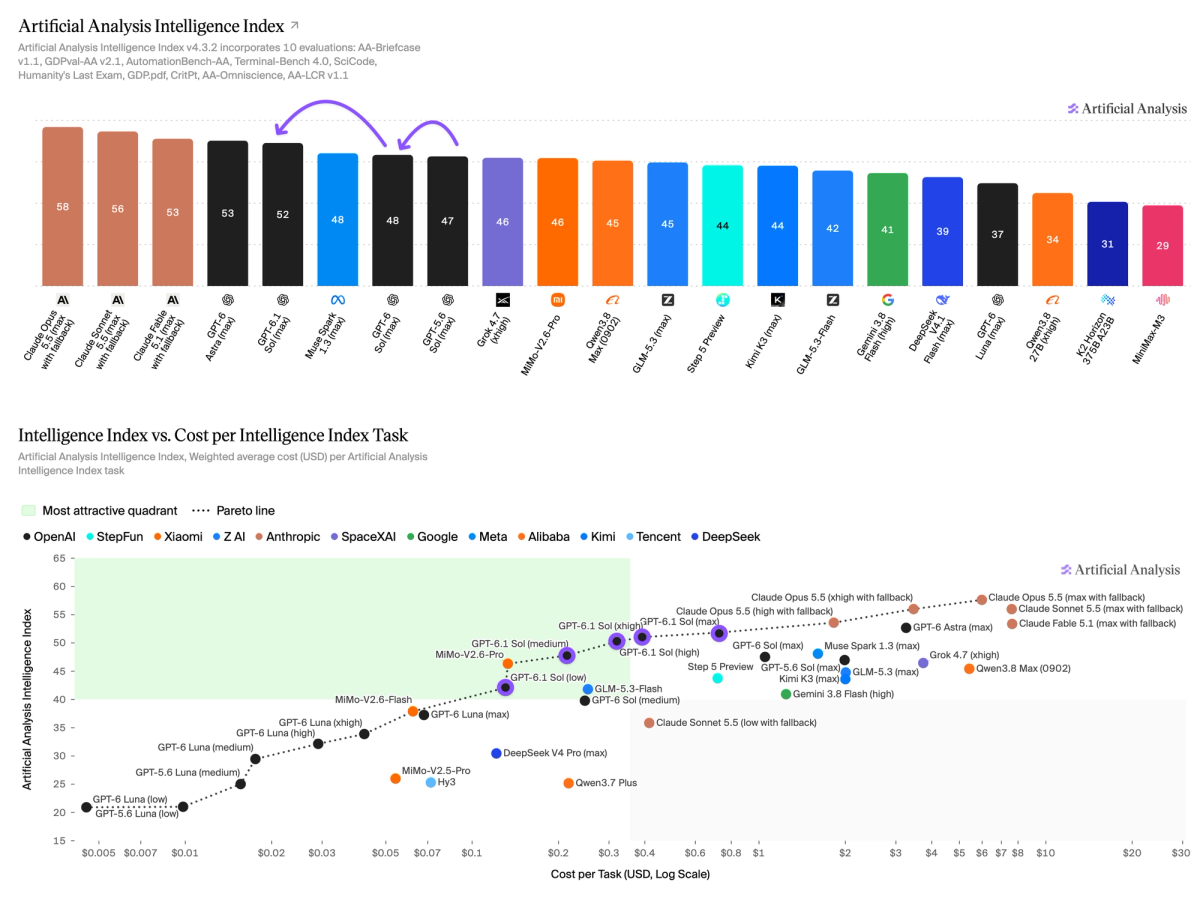
Artificial Analysis. O GPT-6.1 Sol no max fica em 52, um ponto atrás do Astra. Todos os níveis de esforço ficam na fronteira de custo. Astra e Opus ficam mais à direita.
O ajuste é o produto
Na API o id é gpt-6.1-sol. O contexto é de 1,05 milhão de tokens. Ele está na API hoje, e no ChatGPT Work e no Codex para Plus, Pro, Business, Enterprise e Edu. Ainda não está no Chat. Uma faixa Ultrafast, com até 8 vezes a velocidade de geração no Codex, está prevista para os próximos dias. Essa velocidade é um produto separado do preço abaixo.
A Artificial Analysis rodou cinco esforços. O medium já empata o Sol da semana passada no max.
| Esforço | Intelligence Index | Custo por tarefa do índice |
|---|---|---|
| Low | 42 | US$ 0,13 |
| Medium | 48 | US$ 0,21 |
| High | 50 | US$ 0,32 |
| Xhigh | 51 | US$ 0,39 |
| Max | 52 | US$ 0,72 |
O medium em 48 é a nota máxima do GPT-6 Sol, a US$ 0,21 contra US$ 1,05. O último ponto, do xhigh em 51 para o max em 52, quase dobra o preço da tarefa, de US$ 0,39 para US$ 0,72. Os cinco pontos ficam na fronteira de custo: para uma dada nota do índice, a Artificial Analysis não vê um modelo mais barato. Os pontos antigos do GPT-6 Sol saem dessa linha.
O modelo gasta de 10% a 30% mais tokens de saída que o GPT-6 Sol para chegar lá. Low e medium caem na fronteira de eficiência em tokens. O max não. Os tokens são baratos o bastante para o max ainda ganhar em dólares, e verbosos o bastante para ele perder em tokens. A rodada inteira do índice produziu 67 milhões de tokens de saída, abaixo de uma mediana de 82 milhões. Isso é a rodada, não a contagem por tarefa.
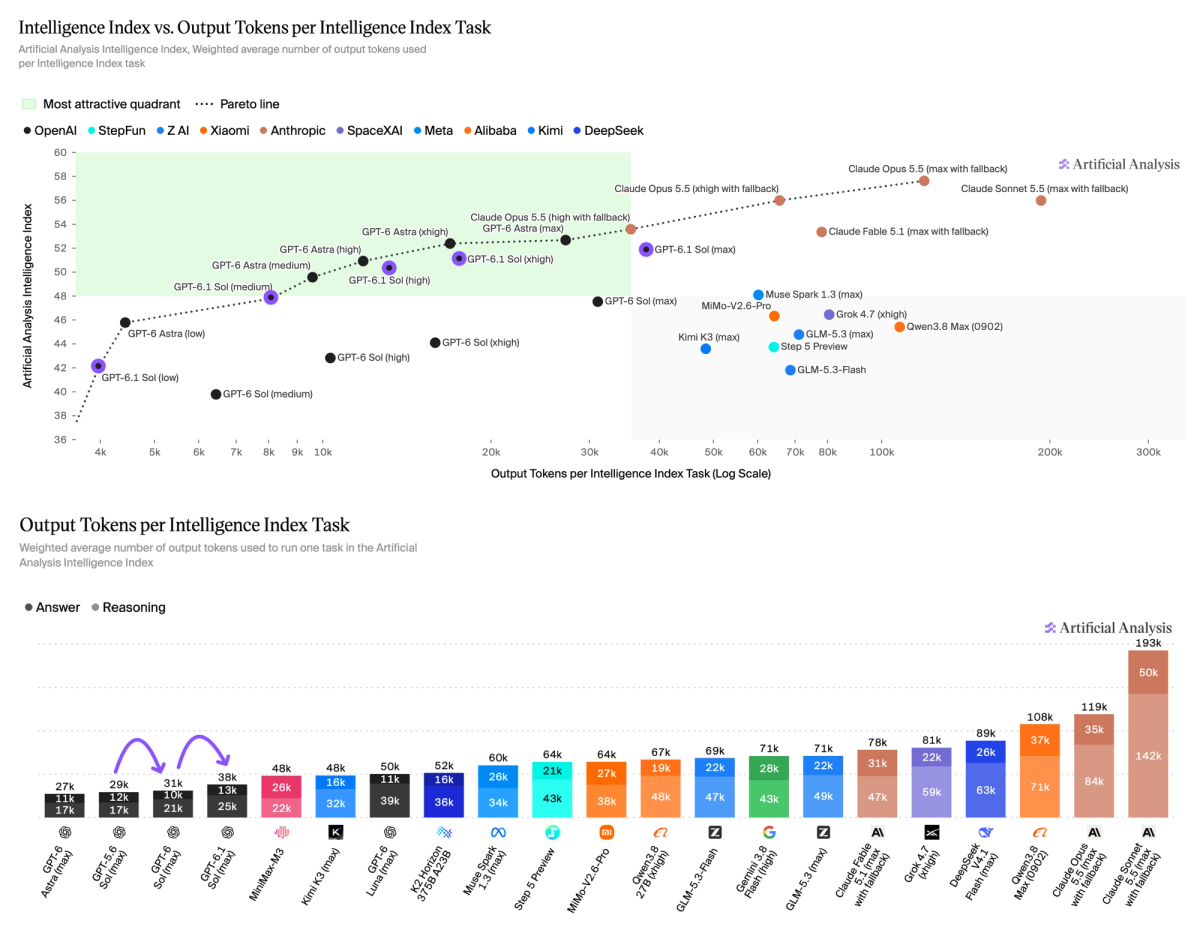
Artificial Analysis. Low e medium ficam na fronteira de tokens. O max usa tokens extras suficientes para sair dela.
Código: compre o xhigh, não a manchete
No Coding Agent Index, no Codex, o GPT-6.1 Sol no max marca 60. São 3 pontos acima do GPT-6 Sol no max, 57, e 2 pontos abaixo do Astra em 62. O xhigh marca 63. É 1 ponto acima do Astra, 3 pontos acima do próprio max, e 6 pontos acima do GPT-6 Sol no max. A Artificial Analysis coloca esse ponto de xhigh em menos de 15% do custo por tarefa de código do Astra.
As barras acima de 63 são outro harness. O Sonnet 5.5 no Claude Code fica em 68. O Opus 5.5 no Claude Code fica em 66. O Fable 5.1 no Claude Code fica em 62, empatado com a nota do Astra no Codex. O Grok 4.7 no Grok Build fica em 56. Um 63 no Codex não é uma ultrapassagem de um 68 no Claude Code. É uma ultrapassagem do Astra no harness que o agente da própria OpenAI usa, por uma fração da conta.
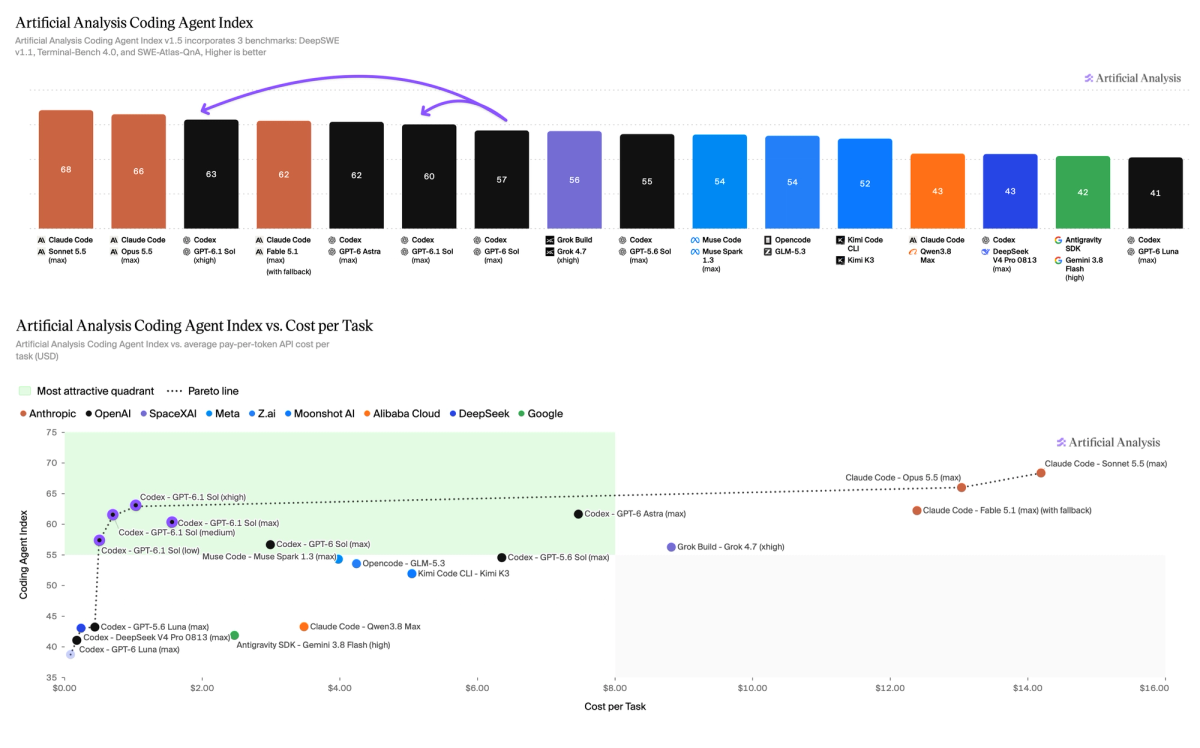
Artificial Analysis. No Codex, o xhigh fica em 63 e o max em 60. O max do Astra no Codex é 62, mais à direita no gráfico de custo.
O trabalho de conhecimento se recuperou. Não assumiu a liderança.
O Sol da semana passada ficou mais barato e mais fino. Este gasta a semana de outro jeito. No AA-Briefcase, a Artificial Analysis mede cerca de 80 Elo acima do GPT-6 Sol, com rubrica mais alta e qualidade analítica mais alta. A qualidade de apresentação escorrega. O gráfico coloca a nota nova na faixa do Astra, e deixa o Opus 5.5 em 1822 e o Sonnet 5.5 em 1811 no topo da mesma figura. Oitenta Elo é uma recuperação real. Não é a liderança em trabalho de conhecimento.
No AA-Omniscience o mecanismo também é diferente do da semana passada. A acurácia sobe 8 pontos. A taxa de alucinação cai de 60% para 54%. A queda da semana passada era sobretudo o Sol tentando menos perguntas. A acurácia deste gráfico é a parcela de perguntas respondidas corretamente entre todas as perguntas, tente o modelo ou não. A taxa de acerto e a taxa de erro se moveram na direção certa. Opus e Astra ainda ficam acima dele nesse índice.
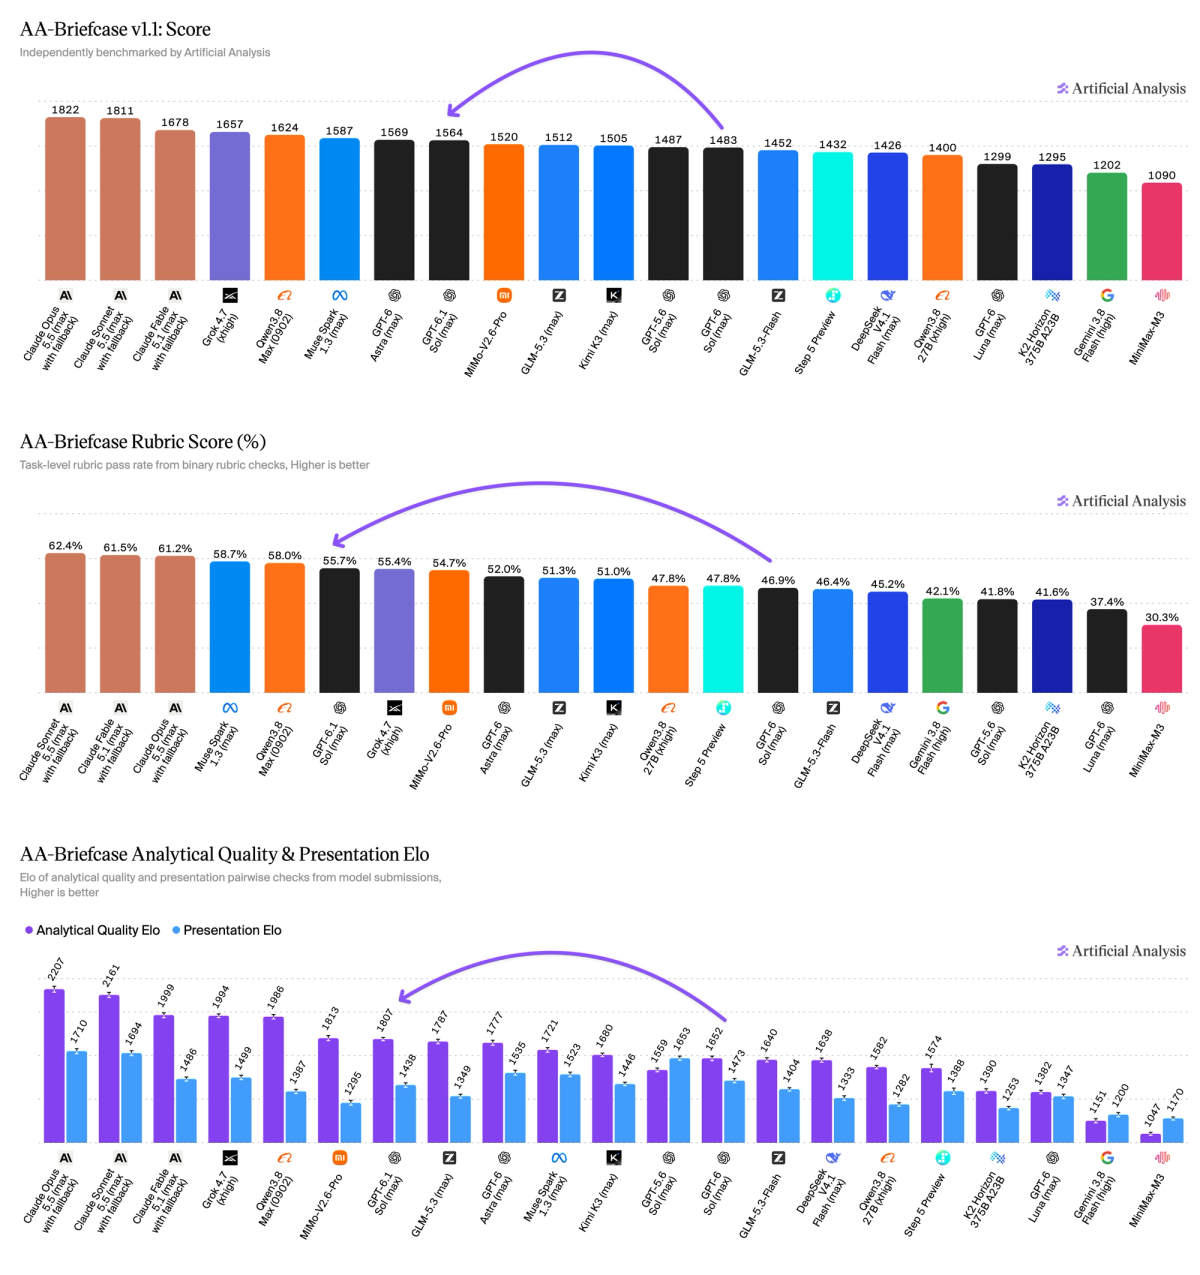
Artificial Analysis. O Briefcase sobe cerca de 80 Elo. A qualidade de apresentação é a série que escorrega.
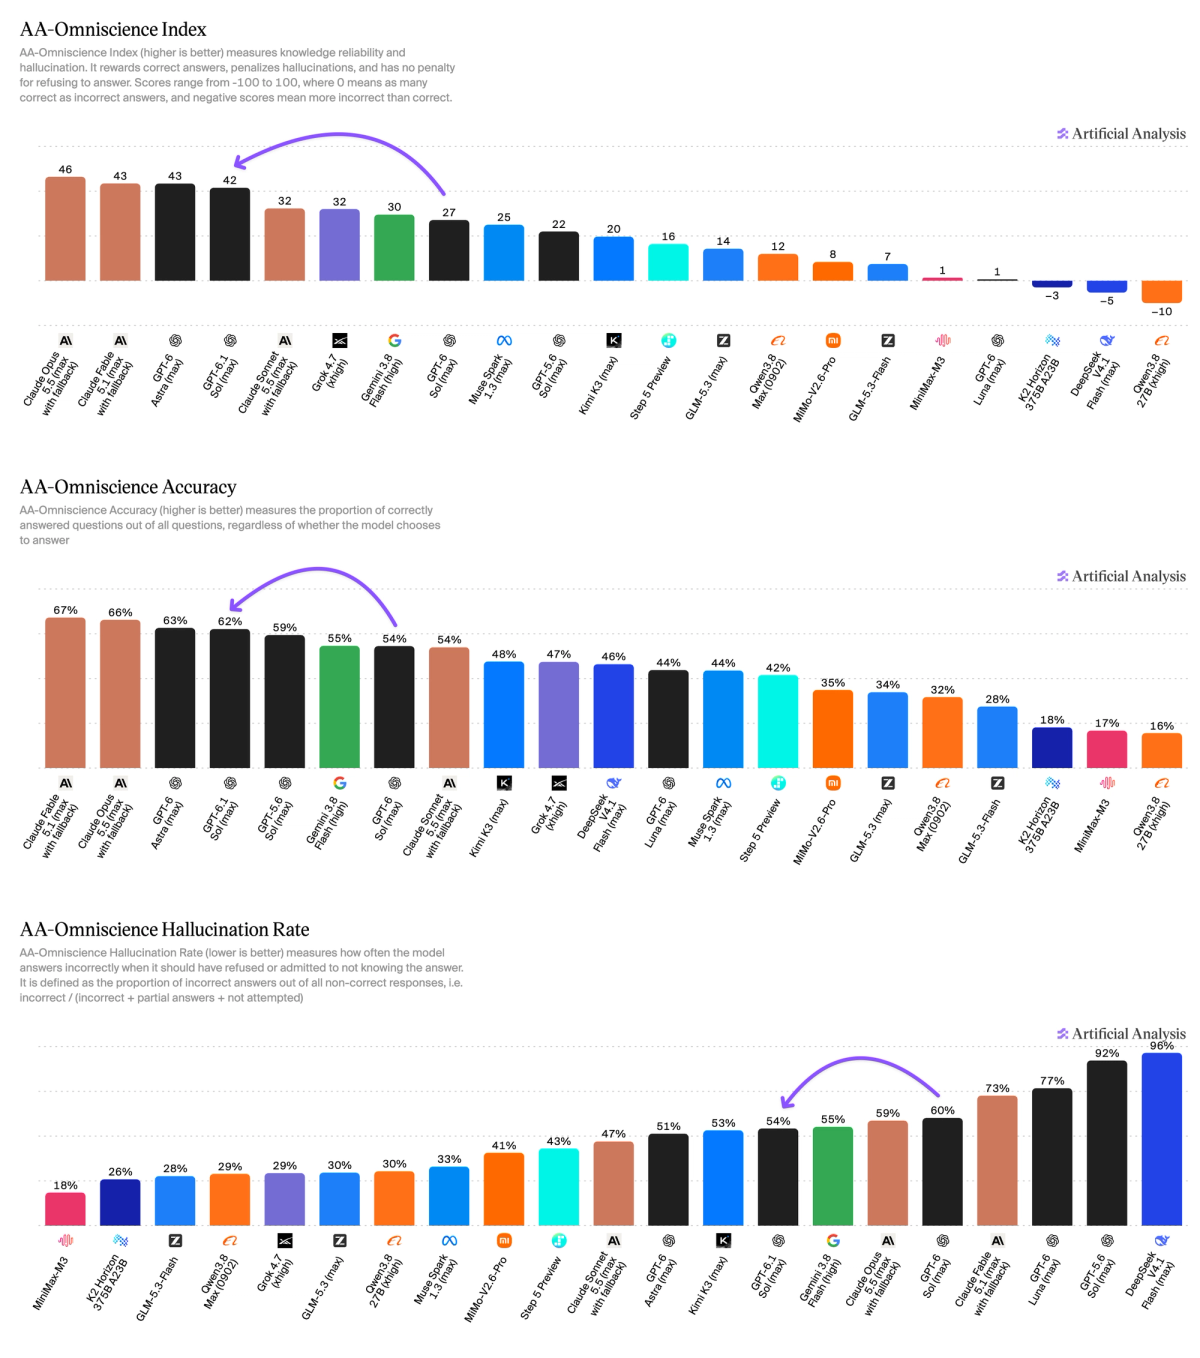
Artificial Analysis. A acurácia sobe 8 pontos. A alucinação cai de 60% para 54%.
O que os gráficos da OpenAI acrescentam, e onde o max é a citação errada
Os gráficos de lançamento da OpenAI não são arquivos para embutir. As alegações abaixo são deles. As linhas do BenchLM são as células de esforço máximo desses mesmos gráficos, e o BenchLM diz que mantém o max mesmo quando um esforço mais baixo pontua mais alto. Essa separação é a parte útil.
No DeepSWE v1.1, a OpenAI diz que o GPT-6.1 Sol empata o Astra por cerca de um quinto do custo, e supera a melhor nota do GPT-6 Sol por 6,4 pontos, num esforço mais baixo e num custo mais baixo do que essa melhor nota. A linha de max do BenchLM é 71,9%. O empate com o Astra não é essa célula de max.
No conjunto offline do OSWorld 2.0, recompensa parcial, a OpenAI diz que o esforço máximo supera o GPT-6 Sol por 7 pontos, fica a 2,1 pontos do Astra e custa cerca de um sétimo por tarefa. O BenchLM lista a cifra do Sol como 71,4% parcial.
No AutomationBench 1.0.6, a liderança que a OpenAI cita é esforço medium: 2,2 pontos acima do Opus 5.5, por cerca de um terço do custo, e 4,8 pontos acima do GPT-6 Sol no mesmo ajuste. A linha de max do BenchLM é 36,1%. A OpenAI também nota que o ponto do Fable nesse gráfico deixa de fora o custo dos fallbacks, que dispararam em cerca de 40% das tarefas do Fable.
No Terminal-Bench Science 0.1, a OpenAI diz que o esforço máximo mais que dobra o GPT-6 Sol, por menos da metade do custo. A tarefa média sai a US$ 5,47, contra US$ 23,21 do Opus 5.5 e US$ 23,80 do Astra. O Astra ainda tem a nota mais alta que eles testaram, 68,1%. O BenchLM lista o Sol em 57,0%. Use o Astra no trabalho científico de terminal mais difícil. Os US$ 5,47 são o motivo para usar o Sol no resto.
No GDP.pdf, a OpenAI diz que o Sol fica acima do Opus 5.5 com fallbacks por menos da metade do custo por tarefa, e se aproxima do Astra por cerca de um quinto do custo. A Artificial Analysis, no GDP.pdf dela, mede um ganho de 6 pontos sobre o GPT-6 Sol.
A checagem de factualidade da OpenAI é uma terceira medição, não o Omniscience. No esforço low, a parcela de respostas com erro factual em conversas difíceis, marcadas por usuários, cai de 11,4% para 7,7%. Entre os esforços que eles testaram, o Sol fica a até 1,9 ponto do Astra, por menos de um quinto do custo. Esses prompts foram escolhidos porque um modelo anterior já tinha errado. Não são um chat típico.
Na prática
- Passe o tráfego do GPT-6 Sol para gpt-6.1-sol. O medium neste índice é 48 a US$ 0,21, a nota máxima da semana passada por cerca de um quinto da conta máxima da semana passada. O preço de tabela continua US$ 2 e US$ 10. O desconto novo é a leitura de cache a US$ 0,10.
- Para agentes de código, use xhigh. No Codex isso é 63, um ponto acima dos 62 do Astra, por menos de 15% do custo da tarefa do Astra. O max é 60. O último ponto do índice, de 51 para 52, é o caro, de US$ 0,39 para US$ 0,72.
- Deixe o Astra no lugar para o trabalho científico de terminal mais difícil. O próprio gráfico da OpenAI ainda tem o Astra em 68,1% e preço da rodada do Sol em US$ 5,47 contra US$ 23,80 do Astra. Deixe o Opus 5.5 no lugar quando precisar do índice em 58 ou do topo do Briefcase.
- Trate a linha "empata o Astra" do DeepSWE e a linha de max de 71,9% como duas citações. O empate é um esforço mais baixo. Os 71,9% são a célula de max do BenchLM.
- Trate a liderança no AutomationBench do mesmo jeito. Os 2,2 pontos sobre o Opus 5.5 são medium contra medium. A linha de max que o BenchLM lista é 36,1%.
- Cite o Terminal-Bench Science como a comparação da OpenAI: o Sol mais que dobra o GPT-6 Sol, o Astra ainda lidera em 68,1%, e os preços da tarefa são US$ 5,47, US$ 23,21 e US$ 23,80.
- As ferramentas continuam na Responses API. O Chat Completions neste modelo não aceita tool calls. O modelo está no Work e no Codex, ainda não no Chat.
Fontes: Introducing GPT-6.1 Sol, Artificial Analysis, a comparação de esforços e o BenchLM. Os cinco gráficos, o índice 52 e a tarefa de US$ 0,72 são da Artificial Analysis. As linhas de DeepSWE, OSWorld, AutomationBench, terminal científico e factualidade são da OpenAI. Os 71,9%, 71,4%, 36,1% e 57,0% do BenchLM são as células de esforço máximo desses gráficos.